Le graphe, le nommage et le schéma comme surfaces contrôlées
Les surfaces structurelles peuvent porter du comportement sans le déclarer. Cet article établit les contraintes qui gouvernent le graphe, le nommage et le schéma pour l’en empêcher.
L’article 6 a établi que les fichiers d’interface peuvent lire directement la couche de données. Cette permission est délimitée : affichage, navigation, contexte de modèle. Elle ne s’étend pas au comportement.
Cette délimitation a été énoncée. Elle n’a pas été appliquée.
L’article précédent contrôlait l’accès. Il ne contrôlait pas le sens. Un fichier d’interface qui lit une relation pour afficher une table externe peut tout aussi bien utiliser cette même relation pour déterminer si un bouton est visible, si un processus est autorisé, si un enregistrement est éligible. La structure permet les deux sans les distinguer.
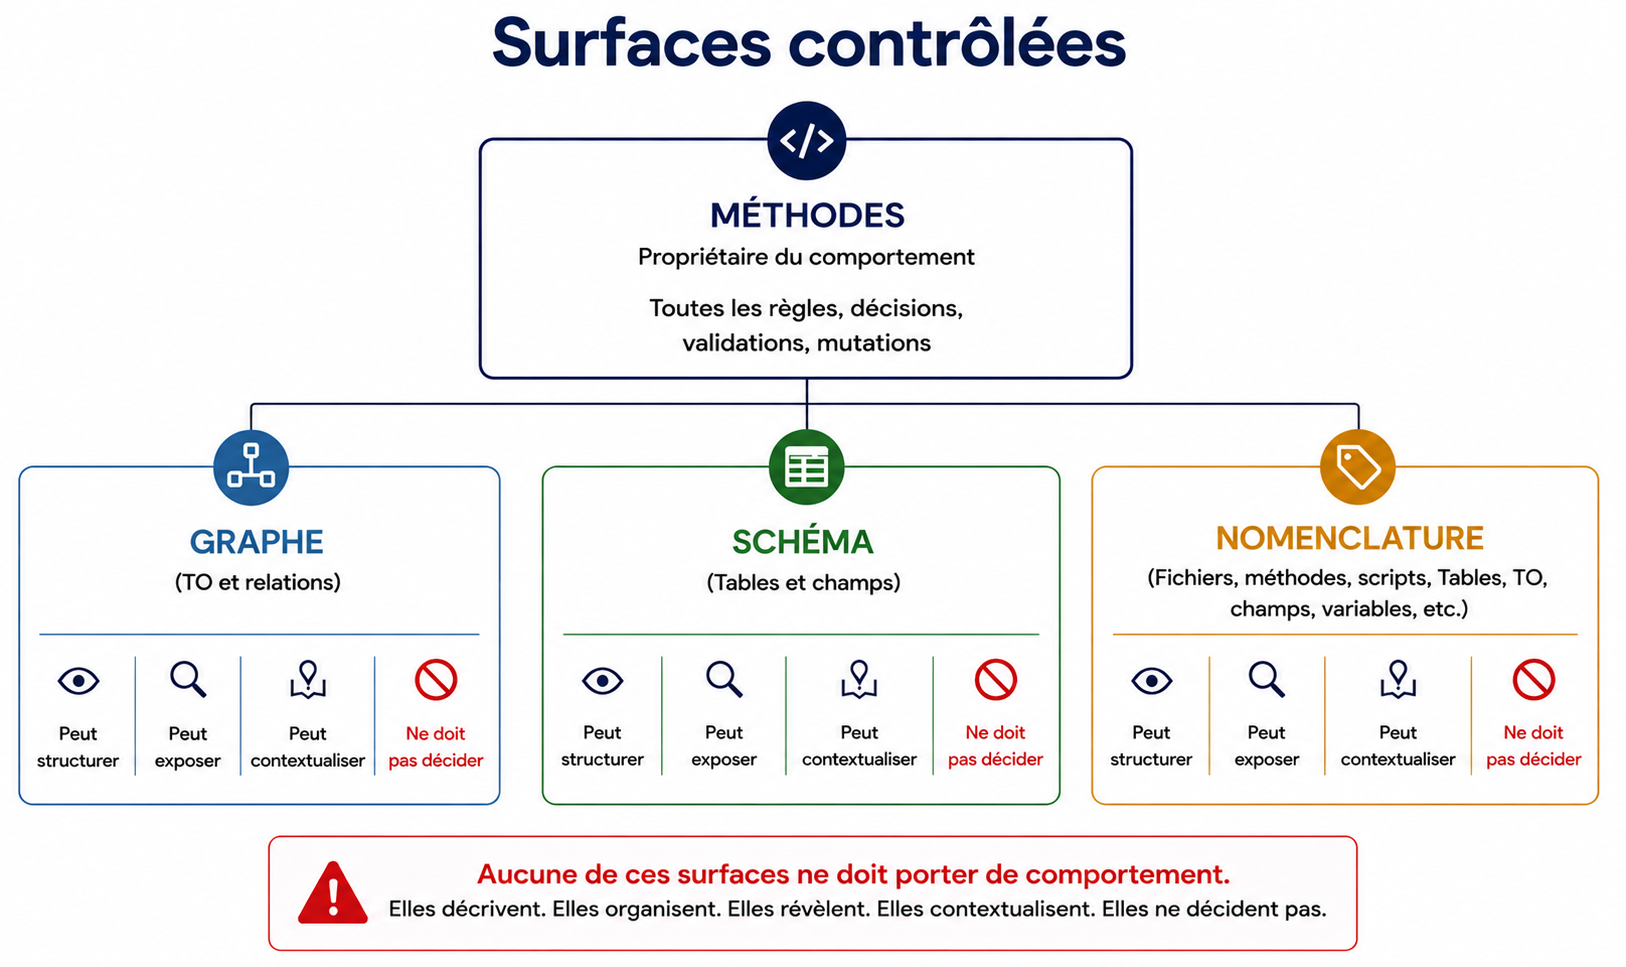
La surface de risque principale est le graphe relationnel. Mais le graphe n’est pas le seul en cause. Le nommage définit comment le système est compris. Le schéma définit ce qui existe. Le graphe, le schéma et le nommage sont des surfaces contrôlées. Une surface contrôlée est un artefact structurel observable qui ne doit pas porter de comportement. Ces surfaces existent indépendamment de l’exécution et sont lisibles par tout développeur accédant au système.
Dans cet article, « Comportement » désigne toute structure qui altère le résultat d’exécution ou détermine l’éligibilité.
Le comportement ne peut exister que dans les méthodes. Quand une surface contrôlée porte du comportement, celui-ci n’a pas de propriétaire déclaré, contourne la couche méthode, et est invisible pour le modèle contractuel du système. Les modèles portent la présentation. Les listes de valeurs contraignent la saisie. Ni l’un ni l’autre n’est conçu pour porter du comportement. Ces trois surfaces le peuvent. Chacune doit donc être contrainte.
Nouveaux concepts introduits
- Surface contrôlée
- Violation de traversée
- Violation de schéma
Le graphe relationnel
Le graphe relationnel de FileMaker — le graphe des occurrences de table — définit deux choses : l’accessibilité des données et les prédicats de jointure. Une occurrence de table rend une table accessible depuis un contexte de modèle. Une relation entre deux occurrences rend les enregistrements d’une table accessibles depuis une autre et définit la condition sous laquelle les enregistrements correspondent.
Voilà ce que le graphe peut faire. Ce qu’il fait dans un système correct est plus restreint : accessibilité pour la présentation, prédicats de jointure pour le contexte de modèle. Il ne doit pas altérer le résultat d’exécution ni déterminer l’éligibilité.
Le graphe relationnel est un mécanisme structurel qui définit l’accessibilité des données et agit comme une surface contrôlée. Le graphe relationnel ne doit pas porter de comportement.
Cette distinction est critique parce que le graphe ne l’applique pas. FileMaker n’empêche pas qu’une relation soit utilisée comme condition, filtre ou règle. La plateforme offre la capacité. L’architecture doit la refuser.
Le critère qui applique cette distinction est mécanique :
Une relation n’est valide que si elle ne porte pas de comportement.
Cela s’applique à la fois à la façon dont les relations sont définies et à la façon dont elles sont utilisées.
C’est une contrainte — pas une directive. Chaque schéma d’échec dans les sections qui suivent produit une relation qui la viole. Il existe deux modes de violation distincts.
Violation par traversée — détection des candidats via l’analyse DDR. Une relation traversée dans un script ou un calcul dont le résultat détermine le comportement est une violation. Parce que les relations doivent être auditables dans les scripts et les calculs, elles doivent être immédiatement reconnaissables dans le code. C’est une exigence de nommage. Elle est traitée dans la section nommage ci-dessous.
Violation de schéma — exposée par révision. Un prédicat de relation ne doit pas encoder un état de domaine ou une classification métier. Les prédicats peuvent définir des relations structurelles — identité, hiérarchie et chemins de navigation — en utilisant des clés et des champs structurels. Les prédicats ne doivent pas référencer des champs qui expriment un statut, une éligibilité ou un état du cycle de vie. Ces champs portent du comportement qui appartient aux méthodes. Les porter dans le graphe introduit du comportement sans propriétaire. Un prédicat référençant statusCode, isActive, ou tout champ exprimant une condition de domaine est une violation au niveau du schéma, que la relation soit consommée par un script ou non. La règle n’a pas de propriétaire déclaré. Elle a le potentiel d’être utilisée. Le contrôle est déjà perdu.
Un graphe relationnel valide supporte la présentation sans porter de comportement. Les enregistrements sont accessibles pour être affichés. Le contexte est établi pour que les modèles fonctionnent. La navigation est possible pour que les utilisateurs se déplacent dans le système. Le graphe n’est pas à éviter — il est nécessaire. La contrainte ne porte pas sur son existence, mais sur ce qu’il porte. Rien dans le graphe ne peut déterminer le résultat d’exécution.
L’article 6 permettait les lectures interface. Cet article contraint leur signification. Une lecture qui porte du comportement a quitté le domaine de la présentation. Elle n’appartient pas au graphe. Elle appartient à une méthode.
Le graphe relationnel est la première surface examinée parce qu’il est le porteur de comportement le plus immédiat dans FileMaker. Les relations et les occurrences de table (OT) sont des structures au niveau du graphe — elles en sont des unités, non des surfaces distinctes. Le nommage et le schéma sont des surfaces contrôlées parallèles, gouvernées par le même invariant, mais à travers des mécanismes différents et avec des chemins de détection distincts.
Les trois surfaces partagent une contrainte
Le graphe a exposé le mécanisme. La même contrainte s’applique aux trois surfaces.
La règle :
- Une relation ne doit pas porter de comportement.
- Un nom ne doit pas encoder de comportement.
- Le schéma ne doit pas intégrer de comportement.
Le comportement a un seul emplacement : les méthodes. Ces trois surfaces ne peuvent pas en tenir lieu.
Le comportement — tel que défini ci-dessus — devient observable partout où de telles structures existent, quelle que soit la surface qui les porte. Une structure porte du comportement si l’altérer ou la neutraliser change le fait qu’une opération soit autorisée, bloquée ou modifiée.
Chaque surface encode le comportement différemment. Une relation l’encode dans un prédicat de jointure ou une condition de filtrage. Un nom l’encode dans une affirmation sémantique sur ce que fait le système. Le schéma l’encode dans une valeur calculée qui participe à l’exécution. Le chemin d’encodage diffère. La violation est la même.
Aucune de ces surfaces n’est primaire. Chacune est un chemin indépendant par lequel le comportement peut entrer dans le système sans passer par une méthode.
Si une structure peut changer ce que fait le système, elle porte du comportement.
Les violations sont binaires. Il n’existe pas de petites violations, de violations temporaires, ni d’exceptions acceptables. Une surface porte du comportement ou elle n’en porte pas.
L’invariant est le même pour les trois surfaces. Ce qui diffère, c’est la façon dont chaque surface est auditée.
Cette contrainte est appliquée différemment selon les surfaces : mécaniquement là où la plateforme le permet, et par audit encadré avec des signaux de défaillance définis là où elle ne le permet pas. Toutes les contraintes ne sont pas mécaniquement applicables — là où la plateforme ne le permet pas, l’application est encadrée et explicite. Chaque surface définit un mécanisme d’audit spécifique avec un signal de défaillance détectable. Ensemble, ils forment le modèle d’audit introduit dans cet article.
Chaque surface définit un signal de violation :
- Graphe → usage de relation exposé via l’analyse DDR (le DDR identifie des candidats ; il n’applique pas la contrainte et ne couvre pas toutes les surfaces)
- Schéma → champ calculé dépendant de champs dont le comportement appartient aux méthodes (violation candidate)
- Nommage → nom exprimant du comportement sans méthode propriétaire
Ce qui se passe avec le temps
Un graphe qui porte du comportement ne l’annonce pas.
La première violation est généralement petite. Une relation utilisée pour alimenter une table externe est aussi utilisée pour compter des enregistrements avant qu’un statut soit défini. Un script lit cette relation et branche sur le résultat. Le graphe porte maintenant du comportement non déclaré. Il n’est pas étiqueté comme tel. Rien dans le système ne le distingue d’une relation purement navigationnelle.
Une deuxième violation suit la première. Un développeur observe la pratique existante et la reproduit. Le graphe relationnel est maintenant le mécanisme établi pour rendre les données disponibles aux scripts. C’est ce que le système enseigne.
Le comportement intégré au graphe n’a pas de propriétaire déclaré. Il n’est pas dans une méthode avec un nom. Il n’est pas dans un module avec une limite. Il existe comme propriété de la surface d’accès aux données — invisible pour quiconque inspecte la couche méthode, absent de tout contrat.
Un comportement sans propriétaire ne peut pas être circonscrit. Il ne peut pas être testé isolément. Il ne peut pas être supprimé sans auditer chaque script qui dépend de l’état du graphe. Il ne peut pas être refactorisé proprement parce qu’il n’y a pas d’origine déclarée depuis laquelle refactoriser.
Le graphe devient une couche logique non déclarée. Pas par conception. Par accumulation.
Le même mécanisme d’accumulation s’applique au nommage et au schéma : dès que l’un ou l’autre commence à encoder des règles, les développeurs suivants lisent cet encodage comme faisant partie de la structure du système et le répètent.
Comment ça échoue
Les pratiques qui introduisent du comportement dans le graphe suivent un petit nombre de formes. Elles sont courantes. Elles sont le résultat naturel de l’utilisation de la pleine capacité de FileMaker sans contrainte architecturale.
Présence de relation comme condition. Un script vérifie si une relation retourne des enregistrements avant de continuer. La relation n’est pas pour l’affichage. Sa présence ou son absence est la condition. Un script dépend d’une relation pour filtrer des enregistrements. Altérer ou neutraliser cette relation change le résultat. → un état comportemental était dérivé du graphe → violation.
État de table externe comme surface de comportement. Un script navigue vers une rangée de table externe via Activer rangée externe, lit la valeur d’une rubrique dans la rangée courante, et branche sur le résultat. L’issue dépend désormais de l’ordre des rangées de la table externe, de l’ensemble des rangées traversables, et de la position de traversée. Modifiez l’ordre de tri de la table externe ou l’ensemble des rangées traversables, et une rangée différente devient courante, une valeur différente est lue, et une branche différente s’exécute. La table externe n’est plus une structure de présentation. Elle participe au comportement à travers son état de traversée.
Structure de jointure comme comportement métier. Deux tables sont jointes via une relation dont le prédicat inclut un champ de statut — seuls les enregistrements correspondant à ce statut sont accessibles. La relation est déjà une violation au niveau du schéma : elle référence un champ exprimant un état de domaine, ce qui porte du comportement sans propriétaire. Son utilisation comme surface de comportement aggrave la violation en faisant de la règle cachée une dépendance d’exécution — un nombre d’enregistrements trouvés utilisé comme condition dans un script, un conditionnel dérivé de la présence d’enregistrements, une vérification d’éligibilité calculée depuis ce que le graphe expose. La règle vit maintenant dans le prédicat de jointure. Elle est invisible depuis le script qui l’utilise. Elle ne peut pas être modifiée sans auditer chaque script qui dépend de cet état du graphe.
Comportement dérivé du schéma. Tout élément de schéma qui produit des valeurs dérivées basées sur des conditions introduit du comportement dans la couche de données. Une rubrique calculée qui référence des données liées directement — sa valeur change quand la relation change, et un script qui lit le résultat a une dépendance qui traverse le graphe. Une rubrique calculée qui dérive un statut à partir de valeurs de rubriques stockées, ou dont la formule référence une rubrique Statistique ou des données liées. Une règle de saisie automatique qui applique une logique conditionnelle. Une rubrique Statistique utilisée en dehors d’un rapport ou d’un contexte contrôlé par une méthode. Chacun de ces éléments produit un résultat qui varie avec l’état du système — ce qui signifie que chacun porte du comportement. Le comportement dans le schéma n’a pas de propriétaire déclaré.
Un élément de schéma qui dépend d’une relation pour produire sa valeur ne déplace pas le comportement vers le schéma. Le comportement reste porté par le graphe. Le schéma est le chemin d’encodage. Le graphe est l’origine. Les deux surfaces sont en violation.
Aucun de ces échecs n’est évident à l’introduction. Chacun se lit comme une utilisation raisonnable des capacités de FileMaker. La plateforme les permet tous. L’architecture ne les autorise pas.
Dès qu’une surface porte du comportement, le système contient deux emplacements de comportement — dont l’un est non déclaré, sans propriétaire, et invisible depuis toute limite de script déclarée.
Le coût de retirer le graphe du comportement
Considérons une règle concrète : un enregistrement parent ne peut pas être supprimé s’il a un ou plusieurs enregistrements enfants.
L’implémentation FileMaker standard est immédiate. Une relation connecte Parent à Child. Le bouton de suppression est conditionnellement masqué avec Not IsEmpty ( Child::id ). Le bouton disparaît quand des enfants existent. Il réapparaît quand ils n’y en a pas. L’utilisateur n’atteint jamais une opération qu’il ne peut pas effectuer. C’est une bonne expérience utilisateur.
C’est aussi une violation.
L’interface dérive l’éligibilité du graphe. La relation n’est pas présente pour l’affichage — elle est présente pour calculer si le bouton doit apparaître. Cette condition est encodée dans un prédicat de jointure et une expression de bouton conditionnelle. La règle peut également exister dans un script qui refusera l’opération si elle est tentée — mais le bouton effectue sa propre vérification d’éligibilité indépendante via le graphe, sans le déclarer. Altérer ou neutraliser la relation rend le bouton toujours visible, quelle que soit l’action du script. Deux surfaces appliquent maintenant la même règle via des mécanismes différents, dont l’un est invisible. Si altérer ou neutraliser une relation change le comportement du système, le graphe portait du comportement → violation.
La contrainte est claire sur ce qui doit se passer à la place. Le bouton de suppression reste visible. L’utilisateur peut tenter l’action. La méthode évalue la règle — y a-t-il des enregistrements enfants ? — et refuse si la condition n’est pas remplie. La méthode possède le comportement. L’interface reflète le résultat.
C’est architecturalement correct. C’est aussi une dégradation de l’expérience utilisateur si laissé tel quel. L’utilisateur voit un bouton, initie une action, et reçoit un refus. Le retour est plus lent. L’interface est moins réactive. Le coût est réel.
La tension est directe : rigueur architecturale contre interface réactive. La contrainte ne résout pas cette tension. Elle l’expose.
Ce qui manque est un mécanisme qui n’existe pas encore dans le modèle. La logique doit posséder le comportement. L’interface doit pouvoir le refléter à coût faible pour s’afficher correctement avant que l’utilisateur agisse. La contrainte a supprimé la solution par défaut — l’éligibilité dérivée du graphe au niveau interface. Elle ne l’a pas remplacée. Le remplacement requiert un état de lecture appartenant à Logic, que l’interface peut consommer sans devenir un porteur de comportement. Ce mécanisme est introduit plus loin dans la série.
Cette surface n’est pas introduite ici. Ce qui est établi ici, c’est qu’elle est nécessaire.
Toute tentative de résoudre ce problème dans le graphe ou le schéma est une violation.
Le coût de la plateforme est réel. Le schéma qui vient d’être qualifié de violation est la réponse par défaut à un besoin légitime d’expérience utilisateur. Chaque système qui applique l’intégrité parent-enfant, les limites de permission, ou les actions dépendantes de l’état doit assumer ce coût. L’architecture ne prétend pas le contraire.
Il reste ceci : l’interface ne dérive pas de comportement du graphe. Les méthodes font autorité. L’interface peut refléter le comportement — afficher un résultat, réagir à un état — mais refléter n’est pas dériver. Dériver du comportement depuis la structure est une violation, quelle que soit la façon dont elle est formulée. Le graphe n’est pas une surface logique. Ça n’a pas changé.
Le graphe expose le comportement caché structurellement. Le nommage l’expose sémantiquement. La surface est différente ; l’invariant est le même.
Le nommage comme contrainte structurelle
Le nommage n’est pas une question de style. C’est une contrainte cognitive qui peut soit renforcer les limites architecturales, soit les affaiblir.
Un nom communique une affirmation sur ce qu’est quelque chose. Si cette affirmation est exacte, le système est lisible. Si elle est inexacte — si le nom affirme quelque chose que le système n’applique pas structurellement — le nom introduit une dérive interprétative. Un développeur lisant le système lit les noms en premier. Les noms exposent la structure du système avant que le code soit ouvert.
Les conventions spécifiques sont illustratives ; la contrainte est structurelle. Les conventions utilisées dans cette série sont un sous-ensemble des conventions propres à l’auteur, partiellement inspirées du travail de Matt Petrowsky et de filemakerstandards.org. Elles ne sont pas proposées ici comme standard. Le lecteur n’a pas besoin de les adopter — seulement de les lire de manière cohérente. Les rubriques utilisent le lowerCamelCase. Les clés étrangères identifient leur cible : partyID. Les variables déclarent leur portée : $local, $$GLOBAL. Les méthodes portent un espace de noms : module.myMethod. Les occurrences de table déclarent leur contexte : Party » Project identifie à la fois la table ancre et le contexte que la bouée sert. Ce qui importe n’est pas la forme — c’est que chaque nom reflète précisément où le comportement est possédé.
Les tables représentent des entités, pas des comportements. Une table nommée Party contient des enregistrements qui sont des parties. Une table nommée ActiveProject affirme une condition que le schéma n’applique pas. L’affirmation appartient à une méthode. Le nom appartient à l’entité.
Les occurrences de table encodent le rôle et le contexte. Dans le modèle Anchor-Buoy, une OT ancre porte le nom de la table qu’elle représente — Party est correct et informatif. Une OT bouée nommée Project ne dit rien au lecteur. Une OT bouée nommée Party » Project dit au lecteur exactement de quelle ancre elle dépend et quel contexte elle sert. Le nom doit être précis quant au rôle.
Les rubriques ne doivent pas calculer de comportement. Une rubrique nommée isApproved stockant un booléen écrit par une méthode est valide. La méthode effectue les étapes d’approbation, détermine le résultat, et le stocke. La rubrique contient la valeur. La validité de cette valeur dépend d’une propriété contrôlée et d’une capacité de reconstruction, introduites plus loin dans la série. La violation survient quand le schéma calcule la valeur lui-même. À ce stade, le comportement vit dans le schéma sans propriétaire déclaré au niveau de la méthode. Il va dériver.
Les méthodes utilisent des verbes qui reflètent la propriété. Une méthode nommée validateProject possède la validation d’un projet. Une méthode nommée check ou process ne déclare rien. Le nom doit être suffisamment précis pour que la suppression de la méthode rende son absence visible.
La règle critique : un nom qui décrit du comportement est un signal. Si une rubrique nommée isApproved est calculée par le schéma, le schéma porte le comportement que le nom décrit. Si une méthode le calcule et stocke le résultat, le nom est précis et la responsabilité est correctement placée.
Les noms sont le premier mécanisme d’application qu’un développeur rencontre. Ils doivent être précis.
Le test est mécanique : si un nom décrit du comportement, localisez où ce comportement est possédé. S’il vit dans le schéma — dans un calcul, une règle de saisie automatique, ou une dépendance relationnelle — c’est une violation. S’il vit dans une méthode déclarée qui écrit le résultat dans la rubrique, ce n’est pas une violation.
isEligible est un nom de rubrique. Un développeur qui le lit apprend que certaines entités sont éligibles et d’autres non. Le nom affirme une condition. La question d’audit est : où cette condition est-elle possédée ?
Si une méthode nommée customers.evaluateEligibility détermine l’éligibilité, le nom est valide. Le comportement a un propriétaire déclaré.
Si aucune méthode de ce type n’existe — si le nom reflète un prédicat de relation, une rubrique calculée, ou une hypothèse implicite — le nom est une violation. La condition qu’il affirme n’est possédée nulle part.
L’audit ne requiert pas d’inspecter chaque rubrique. Il requiert de poser une seule question pour chaque nom exprimant du comportement : où ce comportement est-il possédé ? Si la réponse n’est pas une méthode, c’est une violation.
Le nommage est une contrainte structurelle, pas une préférence stylistique. Il est contraint par un audit encadré avec des signaux de défaillance définis — non automatisable, mais encadré. L’absence d’application mécanique n’affaiblit pas la contrainte. La contrainte est valide parce que le signal de défaillance est défini, pas parce que la détection est automatique. Contrairement au graphe, exposé via l’analyse DDR, les violations de nommage requièrent qu’un réviseur localise où le comportement est possédé. Le signal de défaillance est explicite : un nom qui exprime du comportement doit correspondre à une méthode qui le possède. Si aucune méthode de ce type n’existe, le nom est une violation.
Le schéma
Le schéma est la troisième surface. La même règle s’applique : il ne doit pas porter de comportement.
La limite du schéma est structurelle : une rubrique peut stocker une valeur. Elle ne doit pas calculer une valeur qui porte du comportement. Une rubrique stockée contient ce qui a été placé en elle depuis l’extérieur du schéma — par un utilisateur, par un script, par tout processus d’exécution. Une rubrique calculée dérive sa valeur à partir de conditions définies dans le schéma lui-même.
Toutes les valeurs calculées ne sont pas des violations. Les dérivations d’affichage — formatage, concaténation, transformations de présentation — ne portent pas de comportement et sont autorisées. Les valeurs de saisie automatique administrative — UUIDs, horodatages de création, horodatages de modification — sont des mécanismes de gestion des enregistrements, pas du comportement, et sont autorisées. Ce qui est interdit est toute valeur calculée qui porte du comportement : rubriques calculées dérivant des résultats, règles de saisie automatique appliquant une logique conditionnelle. Le schéma peut contenir le résultat d’un comportement. Il ne doit pas en produire un.
Une rubrique qui porte du comportement doit être stockée et écrite par une méthode — pas calculée par le schéma. Toute rubrique portant du comportement doit être écrite exclusivement par des méthodes. Toute rubrique calculée dont la formule référence des rubriques utilisées dans des méthodes est une violation candidate. Une violation n’existe que si la valeur calculée porte du comportement — confirmée par rapport à la propriété des méthodes via l’analyse de dépendances.
Les rubriques Statistique ne doivent pas être utilisées pour porter du comportement. Deux contextes d’utilisation valides existent : la présentation dans les rapports, et l’agrégation contrôlée dans une méthode où l’ensemble trouvé est établi explicitement et où le résultat ne détermine pas de comportement. Toute utilisation en dehors de ces contextes est une violation.
Une rubrique Statistique List of peut être utilisée pour l’itération uniquement quand l’ensemble trouvé est établi explicitement dans la méthode et que le résultat n’est pas utilisé pour déterminer le comportement. L’ensemble trouvé est une entrée de méthode, pas une condition ambiante.
Le remplacement canonique pour toute rubrique Statistique portant du comportement est une requête explicite et pilotée par les paramètres — entrées déclarées, aucune dépendance à l’ensemble trouvé ou au contexte du modèle, testable isolément.
La plateforme de démonstration introduite dans cet article contient quatre entités : Party, Contact, Project et Item.
Ce n’est pas un modèle de données de production. Ce n’est pas une conception de niveau implémentation. Il est intentionnellement simplifié et délibérément dénormalisé. Il existe pour fournir une surface concrète contre laquelle les contraintes architecturales peuvent être démontrées et testées. Le schéma contient uniquement ce que les contraintes établies dans les articles 1 à 6 permettent d’exister à ce stade. Ce schéma est illustratif. La contrainte s’applique quelle que soit la structure.
Party           Contact
───────         ────────────────
id              id
name            partyID → Party
createdAt       firstName
modifiedAt      lastName
                email
                createdAt
                modifiedAt

Project         Item
──────────      ──────────────────────
id              id
partyID → Party  projectID → Project
name            name
statusCode      statusCode
createdAt       createdAt
modifiedAt      modifiedAt
Relations :
Party    -<  Contact
Party    -<  Project
Project  -<  Item
Propriété par application :
Application Directory  →   Party, Contact
Application Project   →   Project, Item
La clé primaire de chaque table est id. Les clés étrangères suivent le modèle <entité>ID : partyID référence Party, projectID référence Project. Aucune table ne porte une clé étrangère vers une entité non présente dans ce schéma.
statusCode sur Project et Item est une valeur catégorielle stockée. Elle contient des valeurs comme draft, active et closed. Ce n’est pas une assertion dérivée. Elle n’autorise pas l’encodage du comportement dans le graphe. Une méthode qui lit statusCode pour produire un résultat lit une valeur stockée et applique la logique dans sa limite déclarée. C’est valide. Un prédicat de relation qui filtre sur statusCode encode du comportement dans le graphe. C’est une violation.
La distinction est essentielle parce que la rubrique semble identique dans les deux cas. La violation n’est pas dans la rubrique — elle est dans l’endroit où vit la règle.
Chaque rubrique présente dans ce schéma est soit une clé d’identité, une clé étrangère, un descripteur minimal, ou un horodatage d’audit. Aucune rubrique n’est calculée. Aucune rubrique n’affirme un état. Aucune rubrique n’encode une règle.
Le test est mécanique : altérer ou neutraliser tout élément non-stockage du schéma ne doit pas changer le comportement observable du système. Une rubrique calculée qui porte du comportement échoue à ce test. Une règle de saisie automatique qui applique une condition échoue à ce test. Une rubrique Statistique utilisée comme entrée de comportement échoue à ce test. Ce que contient un schéma valide est ce qui survit à cette condition.
Le test d’audit des OT appliqué
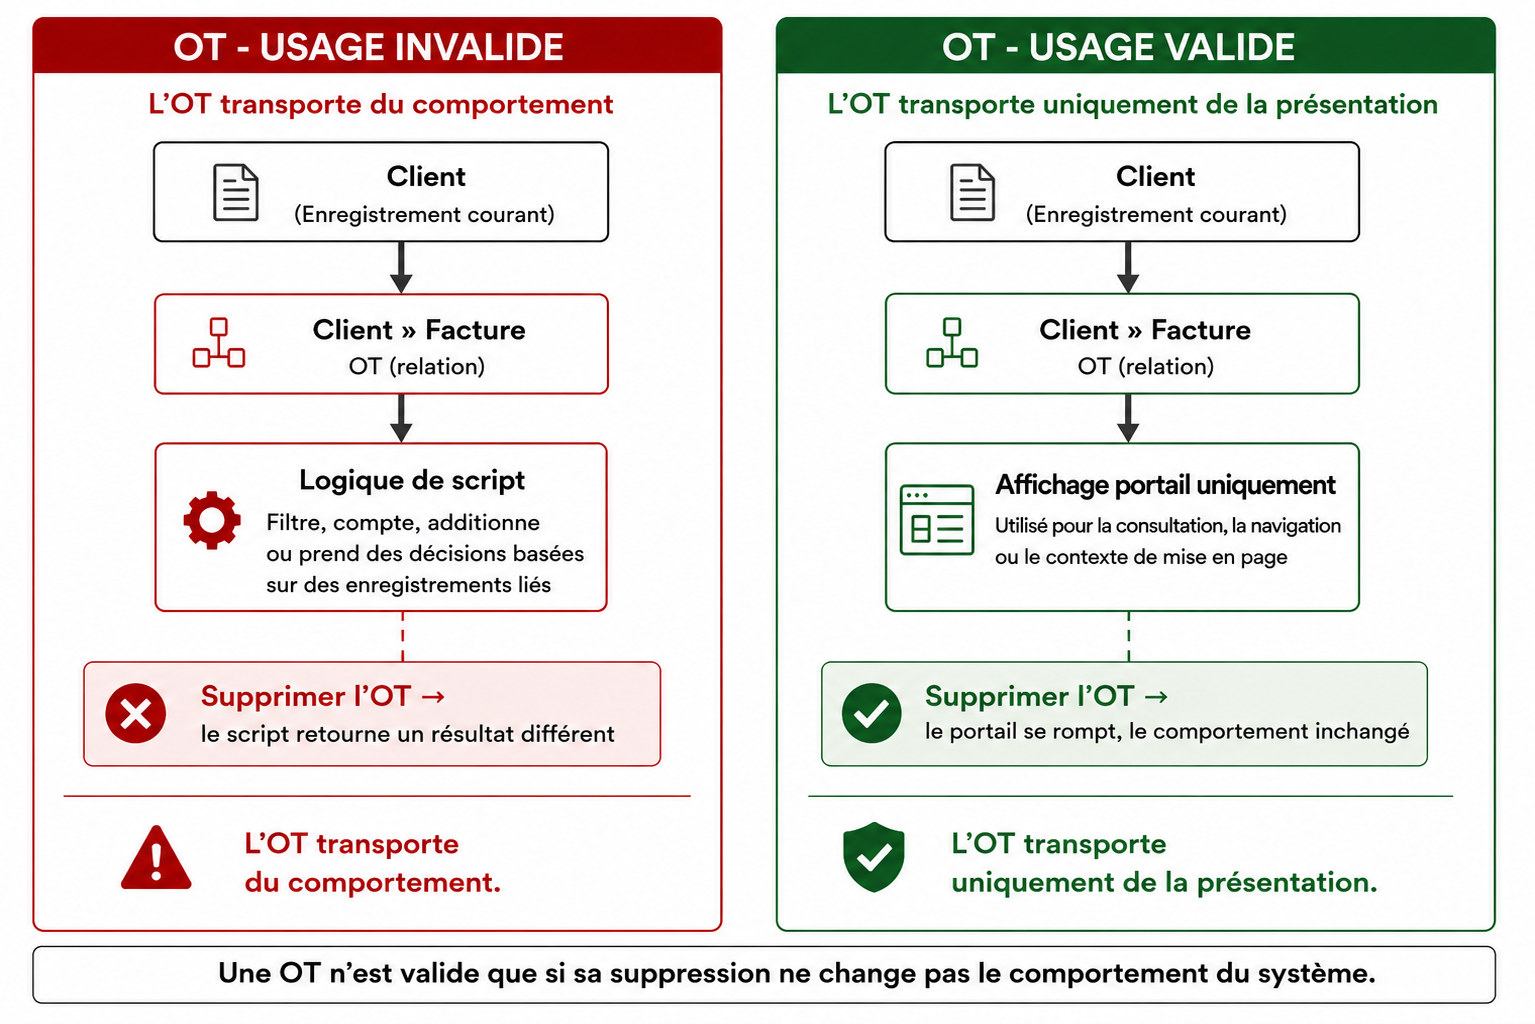
Le graphe relationnel est validé par une condition d’audit : si altérer ou neutraliser une relation change le comportement du système, le graphe portait du comportement → violation.
Cette condition est un invariant d’audit sémantique, pas une procédure de modification destructive. Elle définit ce qui doit être vrai d’un système correct.
L’audit s’applique à l’ensemble du graphe : chaque relation est visée par l’examen. Une relation utilisée uniquement pour le contexte de modèle est valide. Une relation utilisée dans un script ou un calcul dont le résultat détermine le comportement constitue une violation.
L’invariant d’audit s’applique quelle que soit l’architecture de déploiement. Les exemples ci-dessous illustrent le comportement du graphe de manière isolée ; les mêmes violations restent des violations au sein de l’architecture multi-fichiers décrite tout au long de cette série.
Un cas valide. Dans l’application Directory, un modèle Party contient une table externe de contacts. La table externe est pilotée par une relation entre Party et Contact. L’OT apparaît uniquement dans les références de modèle. Aucun script n’en dépend. Altérer ou neutraliser la relation n’affecte que la présentation. Le comportement du système reste inchangé. → le graphe est valide.
Un cas invalide. Un script vérifie si un projet peut être fermé. Sa logique : si le projet n’a pas d’items ouverts, l’opération de fermeture peut se poursuivre. Le script implémente cette vérification en traversant la relation de Project vers Item, filtrée par statusCode = 'open', et en lisant le nombre d’enregistrements liés. Un script dépend d’une relation pour filtrer des enregistrements. Altérer ou neutraliser cette relation change le résultat. → le comportement était porté par le graphe → violation. La relation portait déjà du comportement dans son prédicat — un champ de statut exprimant un état de domaine, portant une condition d’éligibilité sans propriétaire. Le script expose ce comportement en en dépendant.
Ce cas est invalide. La relation porte du comportement — seuls les items ouverts sont qualifiés — dans son prédicat de jointure. La règle — « un projet ne peut être fermé que quand il n’a pas d’items ouverts » — doit vivre dans une méthode. La méthode doit accéder aux données d’item via une requête explicite et pilotée par les paramètres. Elle ne doit pas dépendre de l’état du graphe.
Ce que le graphe peut porter :
- données récupérées pour l’affichage
- contexte de navigation
- contexte de modèle pour les écritures requises par la plateforme
Ce que le graphe ne doit pas porter :
- toute condition qui détermine si une opération peut se poursuivre
- toute logique de filtrage qui porte du comportement
- tout calcul dont le résultat porte du comportement
Le graphe est une surface d’accessibilité et de présentation, pas une surface de comportement.
Ces contraintes gouvernent la surface d’accès aux données. La détection s’effectue au moment de la conception, par audit encadré — l’analyse DDR identifie les candidats de traversée et les références structurellement observables pour le graphe ; le test invariant s’applique au schéma ; la discipline de révision gouverne le nommage. La revue humaine détermine si chaque candidat participe au comportement.
Ce qui change avec cette contrainte
Une fois le test d’audit des OT en place, tout comportement exprimé via la topologie du graphe est architecturalement invalide.
Un développeur qui veut implémenter la règle « un projet ne peut être fermé que quand il n’a pas d’items ouverts » ne doit pas se tourner vers une relation. Il n’existe pas de chemin autorisé de la structure du graphe vers le comportement. La règle doit être déclarée dans une méthode, appliquée à des données explicitement récupérées, et retournée comme résultat. La règle a un propriétaire. Le propriétaire est visible. La logique est testable sans état du graphe.
C’est la même chose pour toute règle qui pourrait autrement être encodée dans un prédicat de jointure, un filtre de table externe, une rubrique calculée traversant une relation, ou un script qui branche sur la présence relationnelle. Aucun de ces chemins n’est autorisé dans le modèle. La logique a un seul endroit : la couche Logic, dans des méthodes déclarées.
Le graphe qui reste est étroit. Les relations n’existent que dans les fichiers interface — elles servent l’affichage et la navigation, rien d’autre. Le fichier Logic ne contient aucune relation. Il contient uniquement un ensemble minimal d’OT de base isolées — une par table — requises pour les modèles d’écriture vierges et l’accès explicite aux données, une concession de plateforme nommée et délimitée dans l’article 6. Le fichier Data ne contient aucune relation. Il contient, pour chaque table de base, l’OT propre à cette table — requise pour que FileMaker dispose d’un contexte permettant d’évaluer un calcul, même un calcul sans contexte réel, une concession de plateforme également nommée et délimitée dans l’article 6 — et rien d’autre.
Un graphe valide est celui où les relations fournissent uniquement l’accessibilité et la navigation, jamais un état comportemental. Un système de nommage valide est celui où chaque nom décrit précisément ce que le système applique structurellement à cet emplacement. Un schéma valide est celui où aucune rubrique ne calcule du comportement.
Modèle d’accès aux données
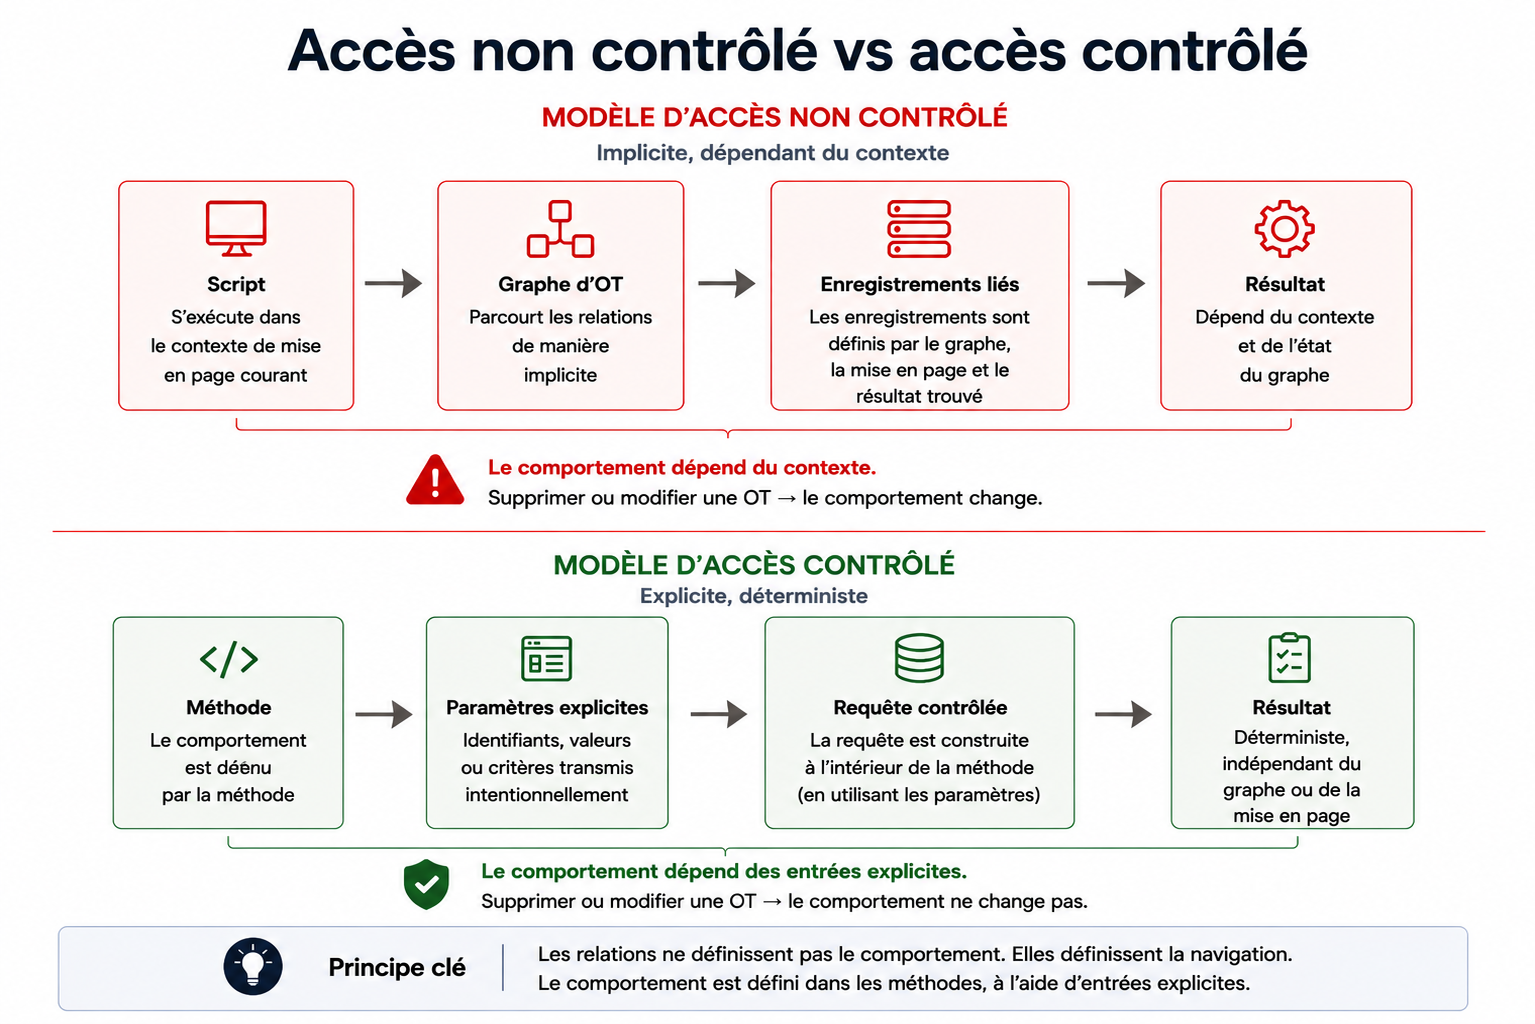
Le graphe définit l’accessibilité. Rendre des données accessibles n’est pas du comportement. Interpréter ces données — déterminer quels enregistrements sont qualifiés, ce que le système en fait, si une opération peut se poursuivre — est du comportement. Le comportement appartient aux méthodes.
Quand la logique basée sur le graphe est retirée, elle doit être remplacée explicitement. Il n’existe pas de substitut implicite.
Voici les contraintes sur l’accès aux données :
- L’accès aux données doit être explicite et piloté par les paramètres. La méthode déclare ce dont elle a besoin. Elle le récupère directement, en utilisant une requête avec des paramètres explicites.
- Aucune méthode ne peut dépendre du modèle actuel, de l’ensemble trouvé, ou du contexte OT hérité pour obtenir des données.
Le schéma d’accès autorisé est une requête explicite et pilotée par les paramètres — que ce soit via ExecuteSQL, une recherche scriptée avec des critères déclarés, ou la Data API de FileMaker. Le mécanisme est secondaire. Ce qui est requis est que la requête déclare ses entrées, établisse explicitement le contexte requis, et retourne un résultat que la méthode possède. La logique de filtrage appartient au corps de la méthode, pas à la structure du graphe.
Ce n’est pas une considération de performance. C’est une exigence de propriété. Une méthode qui dépend de l’état du graphe — modèle actuel, ensemble trouvé, ou contexte OT hérité — ne peut pas être testée sans cet état en place. Elle ne peut pas être routée sans porter son contexte. Elle ne peut pas être raisonnée isolément. Une procédure qui dépend d’un contexte graphique ambiant n’a pas d’identité architecturale — elle n’est pas routable, pas testable isolément, et pas une unité de comportement valide. Elle viole le modèle.
L’accès aux données est explicite, ou il n’existe pas dans le modèle.
La visibilité est l’exigence
Un graphe indiscipliné n’est pas une gêne mineure — c’est le mécanisme par lequel le comportement devient invisible. L’architecture exige que le comportement soit visible. Le comportement basé sur le graphe ne l’est pas.
Le graphe est contraint. Les noms sont contraints. Le schéma ne contient que ce que les contraintes permettent.
La surface observable ne porte aucun comportement implicite.
L’exécution n’est pas contrainte. Les méthodes n’ont pas de contrats déclarés. Les entrées ne sont pas gouvernées. Les sorties ne sont pas garanties — et donc ne peuvent pas encore être vérifiées.
Ressources complémentaires
-
Référence d'article (PDF)
Fiche de référence pour cet article.
-
Plateforme de démonstration (ZIP)
État du schéma et du graphe décrit dans cet article. Aucun comportement ni routage n'est implémenté à ce stade. Disponible en anglais uniquement.
Cet article reflète ma propre expérience et ma perspective. De nombreuses idées ici ont été façonnées par des contributions venues de forums, de communautés, de blogues et de livres blancs. Des outils d'IA ont été utilisés comme assistant à la rédaction pour structurer et affiner le contenu.
Discussion
La discussion est ouverte pour cet article. Les questions, objections, corrections et contre-exemples sont bienvenus.
Envoyer un commentaire privé