La structure que les contraintes exigent
Cet article introduit la structure que les contraintes exigent par déduction — et pourquoi dériver cette structure n’est pas la même chose que la garantir.
L’article précédent a éliminé le modèle par défaut. Pas comme un choix parmi d’autres — comme une conséquence. Un système construit selon ce modèle ne peut pas satisfaire les contraintes établies dans l’article 2. Il ne peut pas les satisfaire partiellement. Il ne peut pas s’en approcher par discipline progressive. Le modèle est structurellement incompatible.
Ce qui reste n’est pas un espace de conception. C’est un résidu.
Un système qui satisfait ces contraintes ne peut pas fonctionner sans rôles distincts. Chaque contrainte exige quelque chose de précis. Ce que chaque contrainte exige peut être nommé. Ce sont ces exigences — pas des décisions de conception — qui définissent la structure.
Nouveaux concepts introduits
- Couche données
- Couche logique
- Couche interface
Les rôles que les contraintes imposent
Les contraintes n’ont pas été établies pour orienter une architecture. Elles ont été établies parce qu’elles sont les conditions sous lesquelles un système reste compréhensible dans le temps. Ensemble, elles exigent trois rôles distincts. Chacun émerge d’une contrainte. Aucun n’est introduit comme composant.
Le rôle de stockage
La contrainte est celle-ci : l’état doit être explicite. Dans un système qui satisfait ces contraintes, les données ne doivent pas exécuter de comportement.
Si une valeur stockée peut déclencher de la logique — via un calcul, une règle de saisie automatique, une structure relationnelle — alors le comportement émerge du schéma plutôt que d’une méthode déclarée. Le comportement n’est plus rattaché à un propriétaire. Il ne peut plus être contrôlé.
Un système qui satisfait cette contrainte requiert quelque chose qui stocke sans décider. Qui contient sans initier. Qui reçoit ce qu’on lui écrit et ne fait rien d’autre.
C’est le rôle de stockage.
Le rôle de mutation
La contrainte est celle-ci : la mutation doit avoir un propriétaire unique. L’exécution doit être déterministe.
Si plusieurs chemins peuvent écrire dans les mêmes données, la valeur finale dépend de l’ordre d’exécution. L’ordre d’exécution n’est pas garanti. Le résultat n’est donc pas déterministe. Si la logique métier peut résider dans n’importe quelle partie du système, elle ne peut pas être testée, tracée, ni modifiée sans risque de régression silencieuse.
Un système qui satisfait ces contraintes requiert quelque chose qui détient exclusivement toute mutation et tout comportement. Rien d’autre n’écrit. Rien d’autre ne valide. Rien d’autre n’applique de règle métier.
C’est le rôle de mutation.
Le rôle d’initiation
La contrainte est celle-ci : les chemins d’exécution doivent être contrôlés. La logique ne doit pas être couplée aux points d’entrée.
Si ce qui initie l’exécution contient aussi la logique, alors le comportement dépend de l’origine de l’appel. Un bouton, un déclencheur, un script planifié — chacun devient un point d’entrée distinct portant sa propre version du comportement. Les règles ne s’appliquent que quand l’interface est impliquée. Elles ne s’appliquent pas sur les autres chemins.
Un système qui satisfait ces contraintes requiert quelque chose qui initie l’exécution sans posséder le comportement qu’il initie. Qui déclenche sans décider. Qui présente les résultats sans les produire.
C’est le rôle d’initiation.
Les couches nommées d’après les rôles
Trois rôles ont été dérivés. Ils peuvent maintenant être nommés.
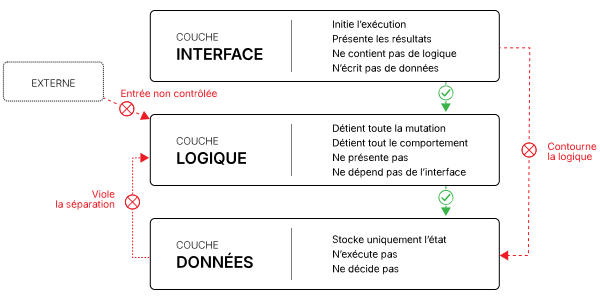
Le rôle de stockage est la couche données. Elle stocke ce qu’on lui écrit. Elle ne décide pas.
Le rôle de mutation est la couche logique. Elle détient toute mutation et tout comportement. Elle ne sait rien de la façon dont ses résultats sont présentés.
Le rôle d’initiation est la couche interface. Elle initie l’exécution et présente les résultats. Elle ne contient pas de règles métier.
Les contraintes entre les couches
Les couches ne sont pas seulement distinctes dans leurs rôles. Leurs relations sont elles-mêmes contraintes.
Dans un système qui satisfait ces contraintes, la couche interface ne doit pas écrire directement dans la couche données. Une écriture directe contourne le rôle de mutation — ce qui revient à avoir plusieurs propriétaires. Ce que cela produit a été documenté dans l’article 3.
Dans un système qui satisfait ces contraintes, la couche données ne doit pas exécuter de comportement. Un comportement dans le schéma dissout le rôle de stockage. La valeur stockée devient une décision. La décision n’a plus de propriétaire déclaré.
Dans un système qui satisfait ces contraintes, la couche logique ne doit pas dépendre de la façon dont la couche interface présente ses résultats. Une telle dépendance couple ce qui doit être séparé. Le comportement devient conditionnel à la présentation.
Dans un système qui satisfait ces contraintes, l’exécution ne doit pas s’initier arbitrairement. Un appel qui passe directement de la couche interface à la couche données — ou qui invoque la couche logique depuis un point non défini — rompt la séparation des rôles. Le chemin entre l’initiation et la mutation doit être contrôlé. Ce qui peut emprunter ce chemin, depuis quel point, dans quel ordre — tout cela doit être déterminable. Un système dont les chemins d’exécution ne sont pas connus ne peut pas garantir la propriété unique de la mutation.
La structure existe. Elle n’est pas encore garantie.
Trois rôles ont été dérivés des contraintes. Trois couches ont été nommées d’après ces rôles. Les relations entre ces couches ont été exprimées comme des interdictions.
Rien de ce qui précède ne garantit que la structure tient.
Un développeur qui connaît ces rôles peut toujours placer de la logique dans la couche données. La couche interface peut toujours écrire directement. Un chemin d’exécution non contrôlé peut toujours contourner la couche logique. La structure est dérivable à partir des contraintes. Elle n’est pas imposée par quoi que ce soit dans le système lui-même.
Ce n’est pas une question de compréhension ou de discipline. Un système dont la structure repose sur la discipline de ses développeurs n’est pas un système structuré — c’est un accord informel. Les accords informels ne survivent pas au changement de contexte, au passage du temps, ni au changement de développeur.
Les contraintes exigent que les violations soient rendues délibérées. Pas découragées. Pas documentées. Délibérées — c’est-à-dire visibles, explicites, et traçables à une décision plutôt qu’à une omission.
Rien dans ce qui a été établi jusqu’ici ne satisfait cette exigence.
Fin du premier mouvement
Les quatre premiers articles ont suivi une progression simple : le problème, les contraintes, les mécanismes d’échec, et la structure que ces mécanismes excluent.
À ce stade, la structure est visible. Ses rôles sont dérivés. Ses interdictions sont posées.
Ce qui reste est une question précise : quelle frontière peut rendre les violations délibérées plutôt qu’accidentelles ?
Ce n’est pas une question de conception. C’est une question d’application. Et elle a une réponse — que la suite de cette série établit.
Pas la seule. Mais pas arbitraire.
Ressources complémentaires
-
Référence d'article (PDF)
Fiche de référence pour cet article.
Cet article reflète ma propre expérience et ma perspective. De nombreuses idées ici ont été façonnées par des contributions venues de forums, de communautés, de blogues et de livres blancs. Des outils d'IA ont été utilisés comme assistant à la rédaction pour structurer et affiner le contenu.
Discussion
La discussion est ouverte pour cet article. Les questions, objections, corrections et contre-exemples sont bienvenus.
Envoyer un commentaire privé